← Tous les projets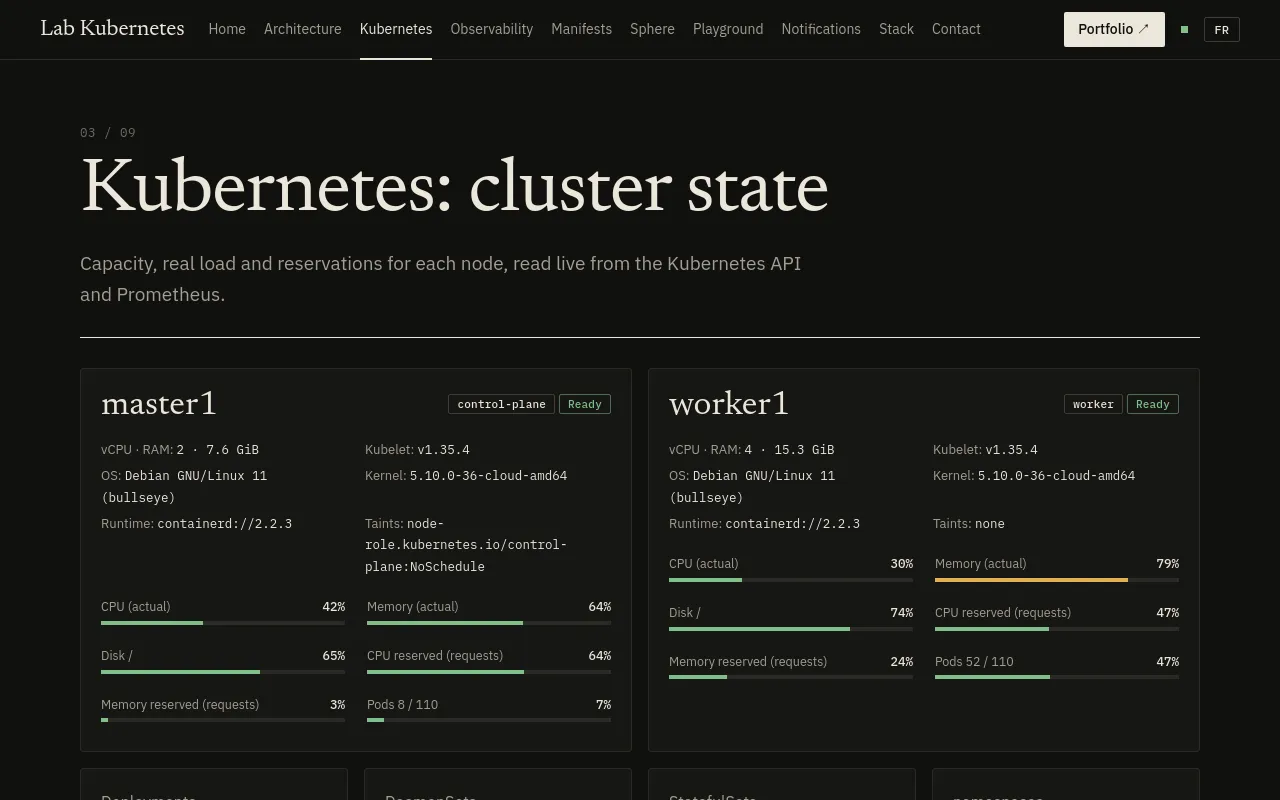
Plateforme · Kubernetes
Un cluster Kubernetes monté et exploité seul
Deux machines, Kubernetes installé avec Kubespray, et tout ce qu'il faut pour héberger des sites publics : entrée HTTPS, certificats automatiques, forge Git, supervision, sauvegardes vérifiées.
- Kubespray
- Calico
- ingress-nginx
- cert-manager
- Helm
- kube-prometheus-stack
- GitLab
- Zabbix
Le problème
Garder la main sur Kubernetes en dehors d'une entreprise, sur une vraie infrastructure exposée à Internet plutôt que sur un poste local, avec les contraintes qui vont avec : sécurité, certificats, sauvegardes, supervision.
Ce que j'ai construit
- Kubernetes installé avec Kubespray : un control plane et un worker, réseau Calico ; metrics-server, stockage local-path et cert-manager en modules.
- ingress-nginx sur les ports 80 et 443 du worker : un seul point d'entrée, un certificat Let's Encrypt pour chaque nom, émis et renouvelé par cert-manager.
- GitLab (forge, CI, registre d'images) et Zabbix installés sur la machine, publiés derrière l'ingress par des Services sans sélecteur : leurs ports ne sont pas joignables depuis Internet.
- Prometheus, Alertmanager et Grafana (kube-prometheus-stack) installés avec Helm, fichiers de valeurs versionnés.
- Sauvegardes nocturnes d'etcd et de sa PKI, de GitLab et de Zabbix, croisées entre les deux machines, sept copies de chaque.
Choix et raisons
- Pare-feu sur l'interface publique du worker : seuls SSH, HTTP, HTTPS, le VPN et l'autre nœud passent. Le kubelet et les exporters ne répondent plus à Internet.
- Pod Security « restricted » sur les namespaces applicatifs, et aucun jeton Kubernetes dans les pods qui n'en ont pas besoin.
- Alertes envoyées par mail directement au serveur du domaine, sans compte SMTP ni mot de passe ; une alerte se déclenche après 30 h sans sauvegarde réussie.
Vérifié
- Snapshot etcd restauré dans un dossier jetable (1 804 clés), archive GitLab complète relue (base et 43 dépôts), dump Zabbix lisible (186 tables).
- L'état du cluster est public et en direct sur lab.hoortrend.com : nœuds, pods, alertes, et un bac à sable que chacun peut casser.
Limites et suite
Un seul control plane et un seul worker : pas de haute disponibilité, c'est assumé pour un lab. Les sauvegardes restent chez le même hébergeur, et le temps de restauration complète n'est pas encore chronométré. Prochaine étape : un exercice de reprise automatisé et mesuré.